Что изменилось в настройках Cloudflare
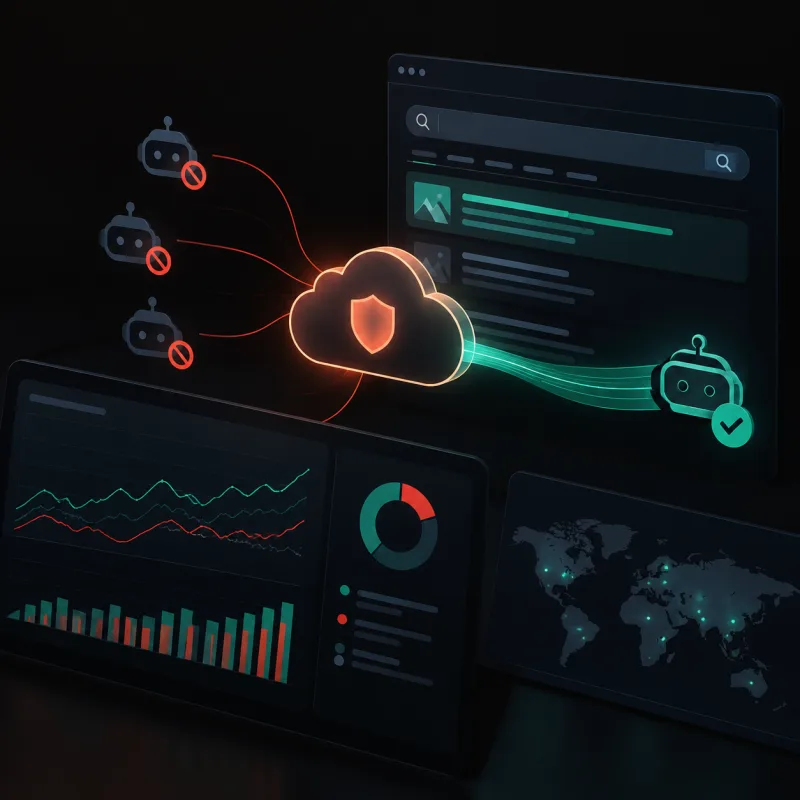
Cloudflare обновил работу функции Disallow AI Training. Теперь она блокирует краулеры, собирающие данные для обучения нейросетей, но пропускает Googlebot.
Раньше настройка работала жёстче — под запрет попадали все боты, включая поисковых. Это создавало проблему: сайты теряли видимость в Google, пытаясь защититься от AI-скрейперов.
Зачем Google получил исключение
Googlebot индексирует страницы для поиска. Его блокировка означает выпадение из выдачи — для большинства проектов это неприемлемо.
Cloudflare разделил краулеры на две категории:
- Поисковые боты (Googlebot, Yandex) — индексируют контент для выдачи результатов пользователям
- AI-краулеры (GPTBot, ClaudeBot) — собирают данные для тренировки моделей
Теперь Disallow AI Training влияет только на вторую группу. Поисковики работают как обычно.
Что с Bing
Bing пока не поддерживает новую логику Cloudflare. Компания планирует внедрить совместимость только к началу 2027 года.
Если ваш трафик сильно зависит от Bing, включать Disallow AI Training рискованно — бот Microsoft может интерпретировать настройку как полный запрет на индексацию. Проверяйте логи после активации.
Как это работает технически
Cloudflare анализирует User-Agent краулера и сверяет его со списком известных ботов. Googlebot попадает в белый список автоматически.
Настройка активируется через дашборд Cloudflare в разделе Security. Никаких правок в robots.txt не требуется — всё управляется на уровне CDN.
Кому это важно
Владельцам контентных проектов, которые хотят:
- Сохранить позиции в Google
- Запретить использование текстов для обучения ChatGPT, Claude и других моделей
- Не редактировать robots.txt вручную под каждого нового AI-бота
Аффилиатам и арбитражникам настройка менее критична — лендинги живут недолго, а уникальность контента там редко приоритет. Но для долгосрочных проектов с авторскими материалами защита от AI-скрейпинга становится частью стратегии.
Стоит ли включать прямо сейчас
Если весь органический трафик идёт из Google — да. Риска для индексации нет.
Если у вас заметная доля из Bing — подождите до 2027 или мониторьте краулинг вручную. Альтернатива — блокировать AI-ботов через robots.txt, но тогда придётся отслеживать появление новых User-Agent самостоятельно.
Cloudflare упростил задачу, но полной универсальности пока нет.