Поисковый трафик уходит, старые правила доверия ломаются, а сайтам приходится заново доказывать, что им можно верить.
Нейросети убьют сайты? Скорее перезапустят. В статье пробуем разобраться, каким станет ближайшее будущее веба, где искать опору для доверия и как будет собираться цепочка от ИИ-ответа до первоисточника.
Что происходит с поисковым трафиком
Традиционные поисковые системы теряют позиции. AI-суммаризация в выдаче Google и других поисковиков означает, что пользователи получают ответы прямо на странице результатов, не переходя на сайты. Это ведет к падению переходов из поиска и ставит под вопрос устоявшиеся модели монетизации контента.
Новая инфраструктура для ИИ
Веб адаптируется к реальности, где основным потребителем контента становится не человек, а модель:
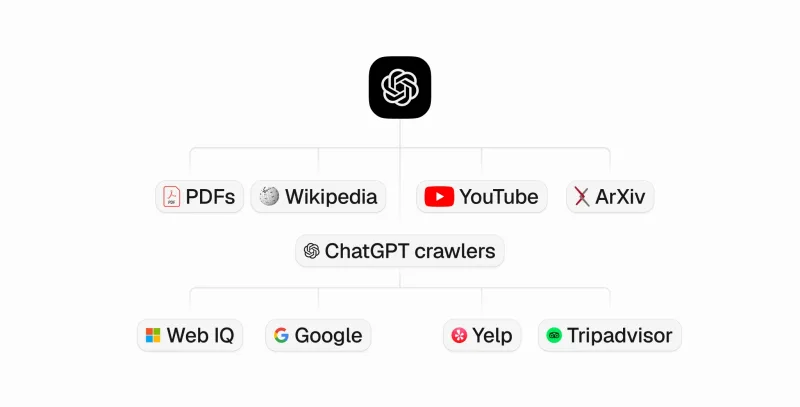
- Краулеры и RAG: поисковые системы нового поколения используют Retrieval-Augmented Generation для формирования ответов на основе индексированного контента
- llms.txt: стандарт для машиночитаемого описания содержимого сайта, позволяющий моделям быстрее понимать структуру и назначение ресурса
- Agent Readability: форматы контента, оптимизированные для чтения агентами, а не людьми
- MCP (Model Context Protocol): протоколы для структурированного обмена контекстом между моделями и источниками данных
- Браузерные агенты: автономные ИИ-системы, способные самостоятельно навигировать по вебу
Проблема доверия и атрибуции
Perplexity и другие ИИ-поисковики столкнулись со спорами вокруг источников: модели агрегируют информацию, но цепочка от ответа до первоисточника часто непрозрачна. Это создает несколько вызовов:
- Как пользователю проверить достоверность ИИ-ответа?
- Как авторам контента получить признание и трафик?
- Как отличить оригинальный контент от сгенерированного?
Markdown-слой и веб для машин
Появляется идея отдельного слоя для моделей — структурированного Markdown-представления контента, параллельного человекочитаемому HTML. Это позволит:
- Оптимизировать передачу информации моделям
- Четко разделить контент для людей и для ИИ
- Снизить вычислительные затраты на обработку
Но возникает риск: веб может разделиться на человеческий и машинный, с разным качеством и полнотой информации.
Технологии верификации
Для восстановления доверия развиваются несколько направлений:
- C2PA (Coalition for Content Provenance and Authenticity): стандарт для криптографической подписи контента, позволяющий отслеживать происхождение и изменения
- Verifiable Credentials: система проверяемых учетных данных для авторов и источников
- Knowledge Graphs: графы знаний для связывания фактов с первоисточниками и отслеживания цепочек доверия
- ИИ-аудиторы: специализированные модели для проверки достоверности ответов других моделей
Что дальше?
Веб не умирает — он трансформируется. Сайты становятся не конечной точкой пользовательского пути, а источниками данных для моделей. Успешными будут те, кто:
- Структурирует контент для машинного чтения
- Внедряет стандарты верификации и атрибуции
- Строит репутацию как надежный источник для ИИ-систем
Вопрос доверия остается центральным: в мире, где ИИ посредничает между пользователем и информацией, механизмы проверки источников должны стать прозрачными и надежными.