Почему нейросеть рассказывает о вас по данным двухлетней давности
Клиент спрашивает у ChatGPT про вашу компанию. Модель называет трех конкурентов, а про вас молчит или путает факты. При этом сайт в топе, трафик из поиска идет, конверсии в норме. Знакомая ситуация?
Первая реакция — переписать тексты, добавить экспертизы, оформить FAQ. Логичная гипотеза: мало контента. На практике она почти не подтверждается. Нейросеть отвечает не по вашему тексту, а по тому, что до нее дошло. И вот здесь начинается самое интересное.
Что видит модель, когда заходит на сайт
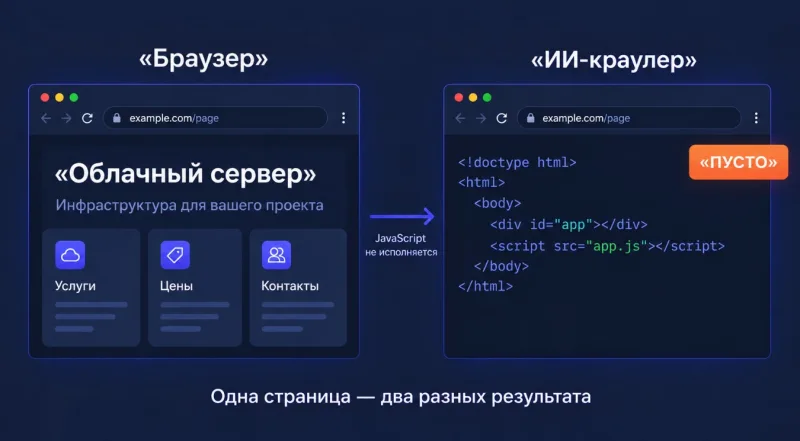
Мы прогнали свой сайт через запросы к разным моделям и посмотрели, что именно получает их инфраструктура. Картина прозаичная. Часть ИИ-краулеров не исполняет JavaScript. Для сайта, который собирается в браузере, это значит одно: до модели вместо статьи доезжает пустой каркас. Пользователь видит прекрасную страницу, а нейросеть — пустой файл.
Представьте: вы вложились в дизайн, анонсы, структуру. А робот приходит и получает болванку без текста. Дальше модель отвечает по тому, что у нее уже есть в памяти или в других источниках. Отсюда и устаревшие данные, и упоминания конкурентов вместо вас.
Где именно теряется контент
Потери случаются на пути от сервера к ответу модели. Разберем типичные места.
Рендеринг на клиенте
Если контент подгружается через JavaScript, краулер без поддержки JS увидит только разметку. Проверить просто: откройте страницу с отключенным JS или посмотрите, что отдает сервер в исходном HTML. Если текста там нет — модель его не получит.
Закрытые зоны
Файлы вроде robots.txt могут запрещать обход. Иногда запрет стоит на весь сайт, иногда на разделы с важным контентом. Модель просто не заходит туда, где вы ей запретили.
Динамические элементы
FAQ, аккордеоны, табы — все, что раскрывается по клику, часто подгружается скриптом. Для робота это невидимый слой. Пользователь видит ответ, нейросеть — нет.
Что проверить в первую очередь
Начните с диагностики. Вот короткий список.
- Откройте исходный код страницы и посмотрите, есть ли там основной текст.
- Проверьте, что отдает сервер без исполнения JavaScript.
- Посмотрите, какие правила стоят в robots.txt для ИИ-краулеров.
- Прогоните сайт через запросы к разным моделям и сравните, что они говорят о компании.
Это не требует переписывать контент. Сначала надо понять, доходит ли он вообще.
Что можно починить
Если проблема в рендеринге, есть несколько путей.
Серверный рендеринг. Отдавайте готовый HTML с текстом. Тогда краулер получает контент сразу, без исполнения скриптов.
Статическая версия для роботов. Если перевести весь сайт на SSR сложно, можно сделать упрощенную версию ключевых страниц.
Дублирование важного в HTML. FAQ, описания услуг, ключевые факты — все, что должно дойти до модели, лучше держать в разметке, а не в скриптах.
Проверка доступа. Убедитесь, что ИИ-краулеры не заблокированы там, где контент должен быть доступен.
Почему переписывание текстов не решает проблему
Можно сколько угодно улучшать статью, но если до модели доезжает пустой каркас, никакие правки не помогут. Это повод проверить техническую сторону, а не бросаться за редактуру. Сначала убедитесь, что контент доходит. Потом уже думайте о качестве.
Вывод
Нейросети читают сайт не так, как люди. Часть краулеров не исполняет JavaScript, и для сайтов с клиентским рендерингом это означает потерю контента. Проверка исходного HTML и доступа для роботов — первый шаг. Если текст не доходит, никакие улучшения не помогут. Начните с диагностики, а не с переписывания.


