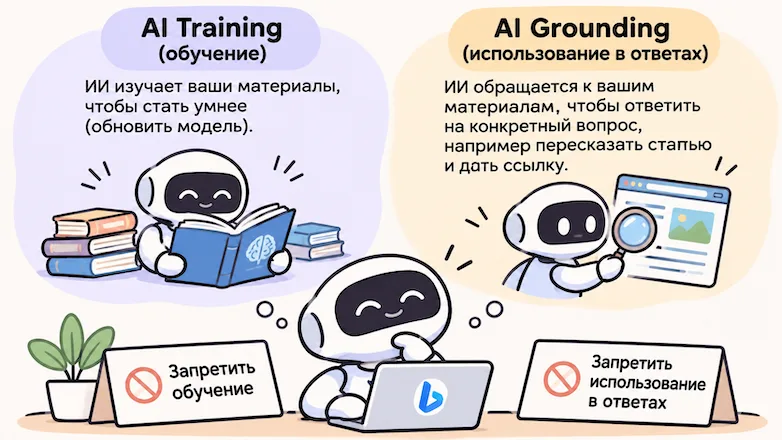
30 октября Microsoft объявила о новых правилах использования содержимого сайтов в своих ИИ-продуктах. Владельцы ресурсов получат возможность отдельно запрещать обучение моделей на своих материалах и использование этих материалов при генерации ответов в Bing и Copilot. При этом страницы по-прежнему смогут присутствовать в обычной поисковой выдаче — то есть отказ от использования контента в ИИ не означает исключения сайта из поиска.
В тот же день Google сообщила, что также намерена поддержать общий механизм запрета на обучение ИИ. Обе компании ориентируются на стандарт, который разрабатывается в IETF. Его смысл в том, чтобы владелец сайта мог устанавливать ограничения сразу для нескольких поставщиков ИИ, а не прописывать отдельные правила для каждого поискового робота и каждой модели.
Сейчас такие запреты приходится реализовывать точечно: через robots.txt, пользовательские соглашения и отдельные технические инструкции для разных краулеров. Единый механизм, поддерживаемый на уровне отраслевого стандарта, должен упростить эту задачу и сделать правила более прозрачными как для издателей, так и для разработчиков ИИ-систем.
Поддержка инициативы двумя крупнейшими игроками рынка поиска и ИИ указывает на то, что вопрос контроля над использованием контента для обучения моделей переходит из плоскости двусторонних договорённостей в область общих технических норм.


